

Gemini 3.5 Flash: interpretar imagens e criar rascunhos rápidos
Da leitura de imagens ao primeiro rascunho: prompts, verificações e divisão de trabalho com Claude, GPT e DeepSeek. Com o material preparado, consulte a página do produto para iniciar os testes.
Antes de interpretar uma captura de tela ou comparar rascunhos, defina o material de entrada e o resultado esperado. Este artigo organiza a leitura de imagens, a primeira versão e as revisões, além de dividir as tarefas entre Gemini, Claude, GPT e DeepSeek.
As funções e o acesso aos testes estão na página do produto Gemini 3.5 Flash.
Para quem é o Gemini 3.5 Flash?
O posicionamento do nível Flash resume-se em três frases:
- Resposta rápida: ideal para alta frequência, rondas curtas e rascunhos imediatos
- Amigável ao multimodal: compreensão mista texto-imagem, perguntas a partir de capturas, leitura rápida de materiais
- Equilíbrio custo/eficiência: o «acelerador por defeito» para escritório diário, estudo e criação leve
Se as suas palavras-chave são «chat Gemini», «Gemini ler imagens» ou «Q&A rápido com IA», costuma encaixar melhor no ritmo quotidiano do que um modelo «flagship de pensamento lento».
Da leitura de imagens ao primeiro rascunho
1. Definir o material e o resultado
Indique se o material contém imagens, texto ou ambos. Peça um esquema, uma tabela ou uma lista de correções. Transcreva textos pequenos que não estejam legíveis para não tratar suposições como informações da fonte.
2. Testar uma tarefa pequena
Limite o primeiro teste a uma captura e peça, por exemplo, três títulos. A página do produto Gemini 3.5 Flash apresenta as funções e o acesso; os formatos aceitos dependem da interface atual.
3. Adaptar o trabalho às entradas
- Texto: ideias, esquemas, traduções e resumos de reuniões.
- Imagem e texto: avaliar um layout, ler tabelas ou responder sobre um gráfico.
- Revisão: propor cinco caminhos → escolher um → desenvolver o rascunho.
Prompts multimodais: como perguntar com mais estabilidade?
Inclua o material, a tarefa e o formato esperado no mesmo prompt:
Esta é uma captura de uma página de detalhe de e-commerce. Por favor: 1) extrai 3 títulos de pontos de venda; 2) aponta módulos com sobrecarga de informação; 3) sugere uma ordem de módulos mais clara. Responde em português, em lista.
Técnicas:
- Declare primeiro a forma de saída (tabela / lista / JSON)
- Limite o âmbito: «critica só o layout, não reescrevas o copy»
- Dê critérios de sucesso: «títulos com no máximo 16 caracteres»
Cenários de alta velocidade: trate o Flash como «motor de rascunhos»
O fluxo real de muitas equipas é:
- Use Gemini 3.5 Flash para produzir rapidamente 3–5 direções
- Use Claude Opus 4.8 para transformar a direção escolhida num texto longo rigoroso (ver guia Claude de escrita e código)
- Use GPT-5.6 Sol para polimento mais geral ou complemento multimodal (ver o artigo irmão abaixo)
- Quando precisar de documentos longos / código com bom custo-benefício, mude para DeepSeek V4
Comparação de cenários com Claude / GPT / DeepSeek
| Cenário | Prioridade |
|---|---|
| Rascunhos rápidos, tentativa e erro em várias rondas, leitura rápida texto-imagem | Gemini 3.5 Flash |
| Estrutura de texto longo, refatoração cuidadosa de código | Claude Opus 4.8 |
| Assistente completo, criação ampla e multimodal | GPT-5.6 Sol |
| Contexto longo, decomposição Agent, alto custo-benefício | DeepSeek V4 |
Também pode ler a comparação online DeepSeek vs GPT no site para completar a «escolha de modelos de chat».
Como encadear com IA de desenho e IA de música?
Cadeia comum em operações de conteúdo:
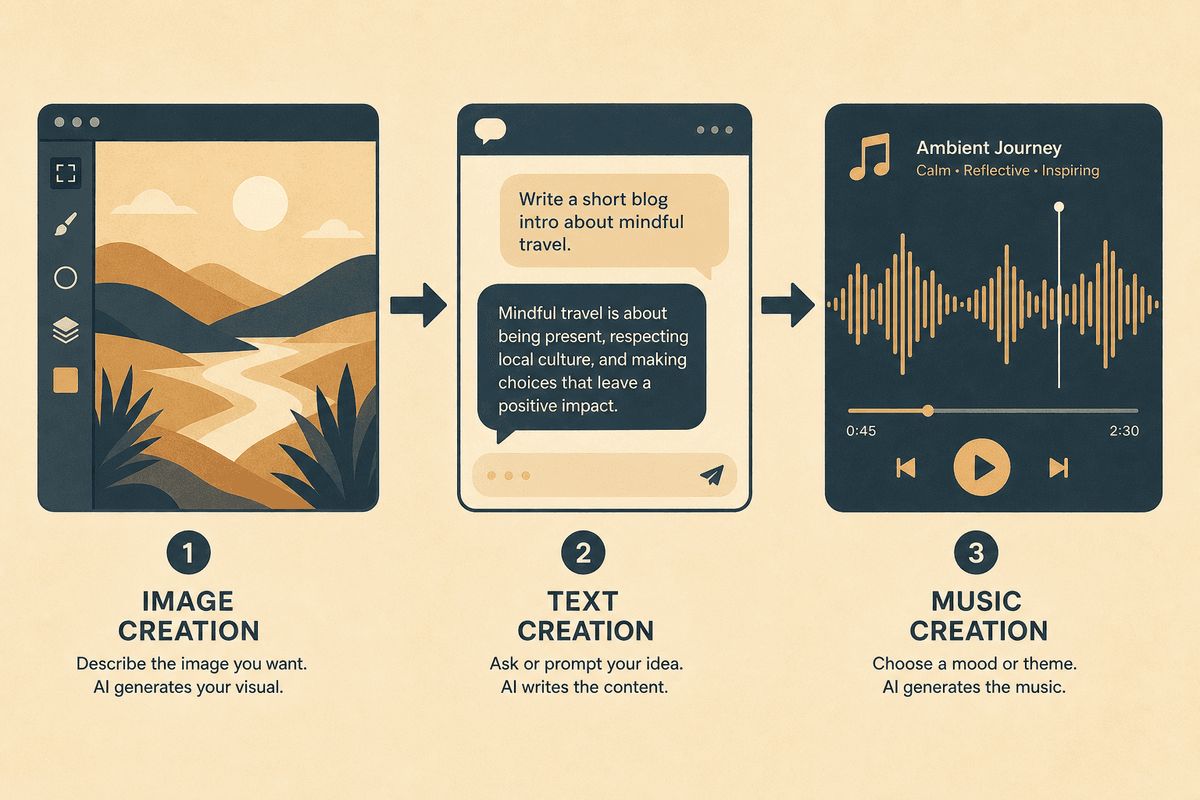
- Gemini escreve rapidamente o guião de cenas e o rascunho de legendas
- Nano Banana / GPT Image 2 / Midjourney V8.1 geram capas e storyboards
- Suno gera BGM para vídeos curtos
Confira o roteiro e as informações antes de passar para imagens e música, para que os erros não se acumulem nas próximas etapas.
Equívocos frequentes
- Equívoco 1: Flash = necessariamente fraco
O Flash destaca-se em velocidade e throughput; para raciocínio pesado e texto longo, mude para Claude / GPT. - Equívoco 2: no multimodal basta deitar a imagem
Sem descrição da tarefa, o modelo só consegue «descrever a imagem»; clarificar o objetivo melhora muito a taxa de resultados úteis. - Equívoco 3: guardar só uma página de modelo
Na revisão, escolha novamente o modelo de acordo com o tamanho das fontes, a estrutura desejada e os resultados verificados.
Preparar o próximo teste
Confira as informações extraídas com as fontes. Depois, revise a estrutura com Claude, reformule com GPT ou organize documentos longos com DeepSeek. Altere apenas o formato, o escopo ou o tom em cada revisão.
Com a tarefa preparada, consulte a página do produto Gemini 3.5 Flash para conhecer as funções e começar.