

Grok 4.5 程式除錯與 Agent 任務拆解:和 GPT / Claude / DeepSeek 怎麼搭配
整理報錯分析、最小修補與 Agent 式任務拆解範本,搭配 GPT、Claude、DeepSeek 做審閱與精修;準備試作時可從 Grok 產品頁進入工作台。
面對報錯或模糊需求,先把根因、最小修補、驗收點與依賴分開,比只要一個答案更容易推進工作。本文整理 Grok 的除錯與任務拆解範本,以及和 GPT、Claude、DeepSeek 的分工。
這裡的 Agent 式拆解指產出任務清單與驗收標準;是否能執行工具,取決於實際工作環境。準備試作時,可閱讀 Grok 4.5 產品頁 的能力與入口。相關教學:
- 全能預設項:線上使用 GPT-5.6 Sol
- 長文與程式碼審慎度:Claude Opus 4.8 指南
- 多模態提速:Gemini 3.5 Flash 指南
- 長上下文對比:DeepSeek 與 GPT 線上對比
- 跨品類流水線:短影片/電商 AI 內容一站做完
Grok 4.5 更適合扛哪一類任務?
把 Grok 當成「編碼與知識工作的高效入口」通常比當成泛聊天更準:
| 場景 | Grok 是否優先 | 說明 |
|---|---|---|
| 讀報錯、定位 bug、給最小修補 | 優先 | 強調可執行修復路徑 |
| 模糊需求 → 步驟清單 / Agent 拆解 | 優先 | 把聊天變成推進動作 |
| 會議紀要、方案摘錄、競品材料壓縮 | 適合 | 先出結構,再決定是否精修 |
| 超長材料一次性灌入梳理 | 可搭配 DeepSeek V4 | 長上下文與性價比拆解更穩 |
| 極致長文結構 / 嚴謹程式碼審閱 | 可切換 Claude Opus 4.8 | 審慎度與結構感更強 |
| 日常預設助手、多模態隨手問 | 可切換 GPT-5.6 Sol / Gemini 3.5 Flash | 覆蓋面或速度優先 |
選型原則:先定交付物,再定模型;不要先死磕品牌名。
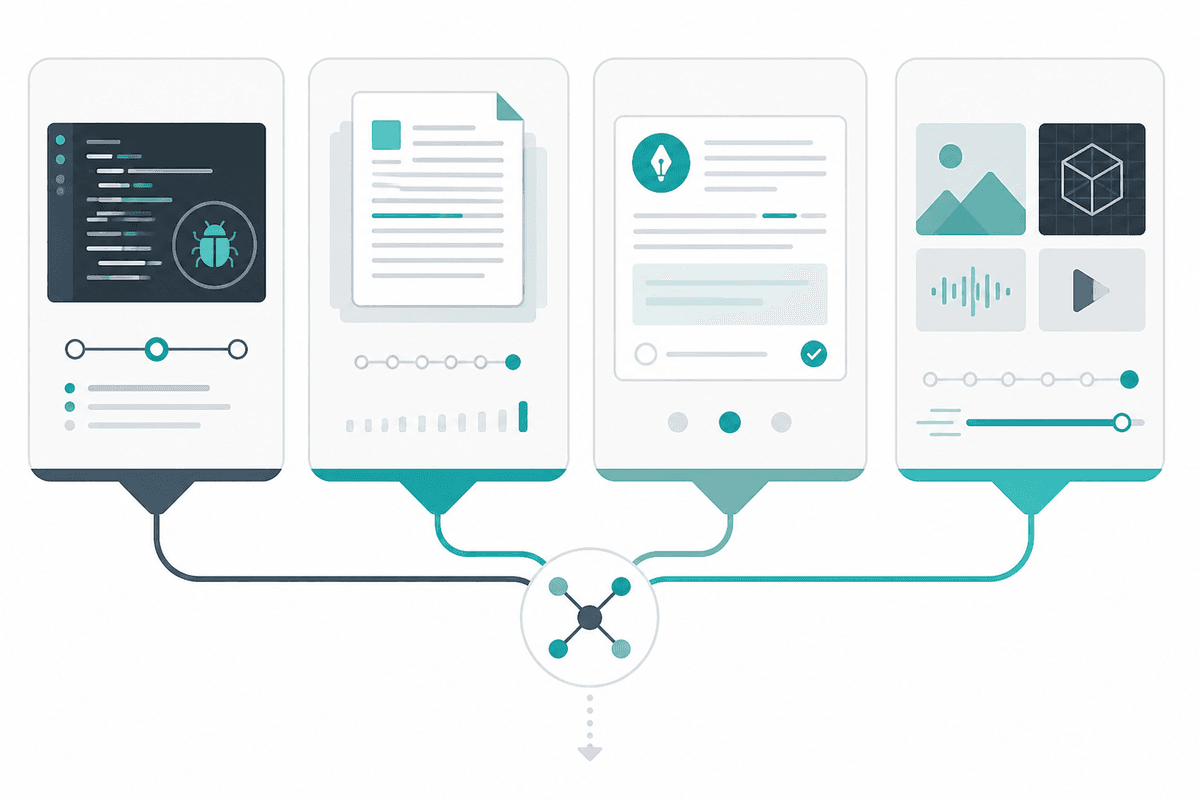
三步把問題變成可驗收的任務
- 準備材料:附上報錯、相關函式、預期行為與已嘗試的方法;需求拆解則先列目標、期限與限制。
- 指定交付物:要求「根因假設 + 最小修補 + 迴歸點」,或「任務 + 依賴 + 驗收標準」。準備試作時,從 Grok 4.5 產品頁 進入工作台。
- 驗證再精修:在自己的環境測試修補,核對拆解是否漏掉依賴;需要二次審閱時,再搭配 Claude、GPT 或 DeepSeek。
模型產出的修補與清單是待驗證草稿,應以實際測試和人工驗收決定是否採用。
高品質提示詞範本(可直接改寫)
編碼排錯:
解釋這段報錯的根因,給出最小修復修補,並列出 3 個迴歸測試點。程式碼/日誌如下:……
Agent 式任務拆解:
把「本週上線活動落地頁」拆成 7 天執行清單,表格輸出:任務、依賴、負責人欄位、驗收標準、風險。
長材料摘要:
把下文整理成三欄:決策 / 待辦(負責人+截止日期)/ 風險。不要抒情。原文:……
方案初稿:
為獨立開發者工具站寫一版 PRD 大綱:問題、使用者、核心流程、MVP 範圍、非目標。控制在 600 字內。
學習答疑:
用初學者能懂的方式解釋「什麼是 Agent」,給 2 個生活類比,再給 1 個可動手的小練習。
和 GPT、Claude、DeepSeek、Gemini 怎麼組合?
推薦一條「模型路由」——也是很多一人團隊真實在用的順序:
| 階段 | 模型 | 原因 |
|---|---|---|
| 快速拆解 / 編碼試錯 | Grok 4.5 | 先拿到可執行步驟或修補方向 |
| 全能成稿與改寫 | GPT-5.6 Sol | 表達自然、覆蓋面廣 |
| 長文/程式碼精修 | Claude Opus 4.8 | 結構與審慎度更強 |
| 超長材料梳理 | DeepSeek V4 | 長上下文與清單化 |
| 高速多輪 / 輕量多模態 | Gemini 3.5 Flash | 更快試錯 |
更深對比可參考:DeepSeek vs GPT、Claude 長文與程式碼、Gemini 多模態、GPT-5.6 Sol 上手。
三條可複製的工作配方
配方 A:修一個線上 bug(30–60 分鐘)
- Grok:貼上報錯與相關函式,要「根因 + 最小修補 + 迴歸點」
- Claude Opus 4.8:對修補做二次審閱(邊界條件、命名、測試)
- 需要寫發布說明時,用 GPT-5.6 Sol 出對內/對外兩版語氣
配方 B:從模糊需求到可執行清單
- Grok:把目標拆成按天任務表
- DeepSeek V4:若材料很長(舊文件/競品頁),先灌入再壓縮成清單
- 落地頁文案交給 GPT-5.6 Sol;封面用 Midjourney / GPT Image 2 / Nano Banana
配方 C:知識口播或教學切片
常見踩坑
- 只問「幫我看看」:沒有目標與輸出格式,模型只能空泛回答。寫清交付物。
- 一個模型包打天下:編碼入口用 Grok,長文審慎度用 Claude,長上下文用 DeepSeek,預設助手用 GPT。
- 跳過驗證:修補看起來合理仍可能漏掉邊界條件;先跑相關測試,再檢查是否影響既有行為。
- 商用與敏感資料:投放或處理內部材料前,確認工作台套餐與平台條款。
任務與模型速查表
| 任務 | 參考入口 | 下一步 |
|---|---|---|
| 報錯分析與任務拆解 | Grok 4.5 | 編碼、拆解、知識工作開聊 |
| 成稿與改寫 | GPT-5.6 Sol | 預設寫稿與改寫 |
| Claude 寫長文 / 程式碼審閱 | Claude Opus 4.8 | 結構精修 |
| 長材料梳理 | DeepSeek V4 | 大材料梳理 |
| Gemini 多模態 / 又快又強 | Gemini 3.5 Flash | 快速試錯 |
| Midjourney / GPT Image / Nano Banana | 繪畫選型指南 | 封面與主圖 |
| 內容配樂 | Suno | BGM 與成曲 |
下一次除錯怎麼做?
先準備可重現的報錯與預期行為,用 Grok 整理根因假設與最小修補,再執行測試。需要二次審閱時交給 Claude,發布說明可由 GPT 起草,長材料則先用 DeepSeek 梳理。
若是模糊需求,先要求包含依賴與驗收標準的任務表,再逐項核對。準備試作時,從 Grok 4.5 產品頁 查看能力與入口,帶著上面的範本完成一個小任務即可。